近年、Webアプリケーション開発の世界で注目を集めている技術がGraphQLです。従来のRESTful APIに代わる新しいAPI設計パラダイムとして、多くの開発者やテック企業から支持を得ています。
GraphQLは、クライアントがサーバーから必要なデータを柔軟かつ効率的に取得できるようにするクエリ言語およびランタイムです。Facebookが2012年に社内で開発し、2015年にオープンソース化されて以来、その人気は急速に拡大しています。
なぜGraphQLがこれほど注目されているのでしょうか?その理由は、データ取得の効率性と開発の柔軟性にあります。GraphQLを使用することで、クライアントは必要なデータを正確に指定でき、サーバーは過不足なくそのデータを返すことができます。これにより、不要なデータのやり取りを減らし、アプリケーションのパフォーマンスを向上させることができるのです。
また、GraphQLは強力な型システムを持っており、APIの設計と使用を明確にします。これは、フロントエンドとバックエンドの開発者間のコミュニケーションを改善し、開発プロセス全体を効率化します。
本記事では、GraphQLの基本概念から特徴、メリット・デメリット、そして実装方法まで、初心者の方にもわかりやすく解説していきます。GraphQLがもたらす革新的なアプローチを理解し、あなたのプロジェクトに活用する方法を探っていきましょう。
GraphQLとは
GraphQLは、APIのためのクエリ言語であり、既存のデータに対するクエリを実行するためのランタイムです。2012年にFacebookによって社内で開発され、2015年にオープンソースとして公開されました。
GraphQLの名前の由来は「Graph Query Language」の略で、その名の通り、データをグラフ構造として捉え、必要な部分だけを柔軟に取得できるように設計されています。
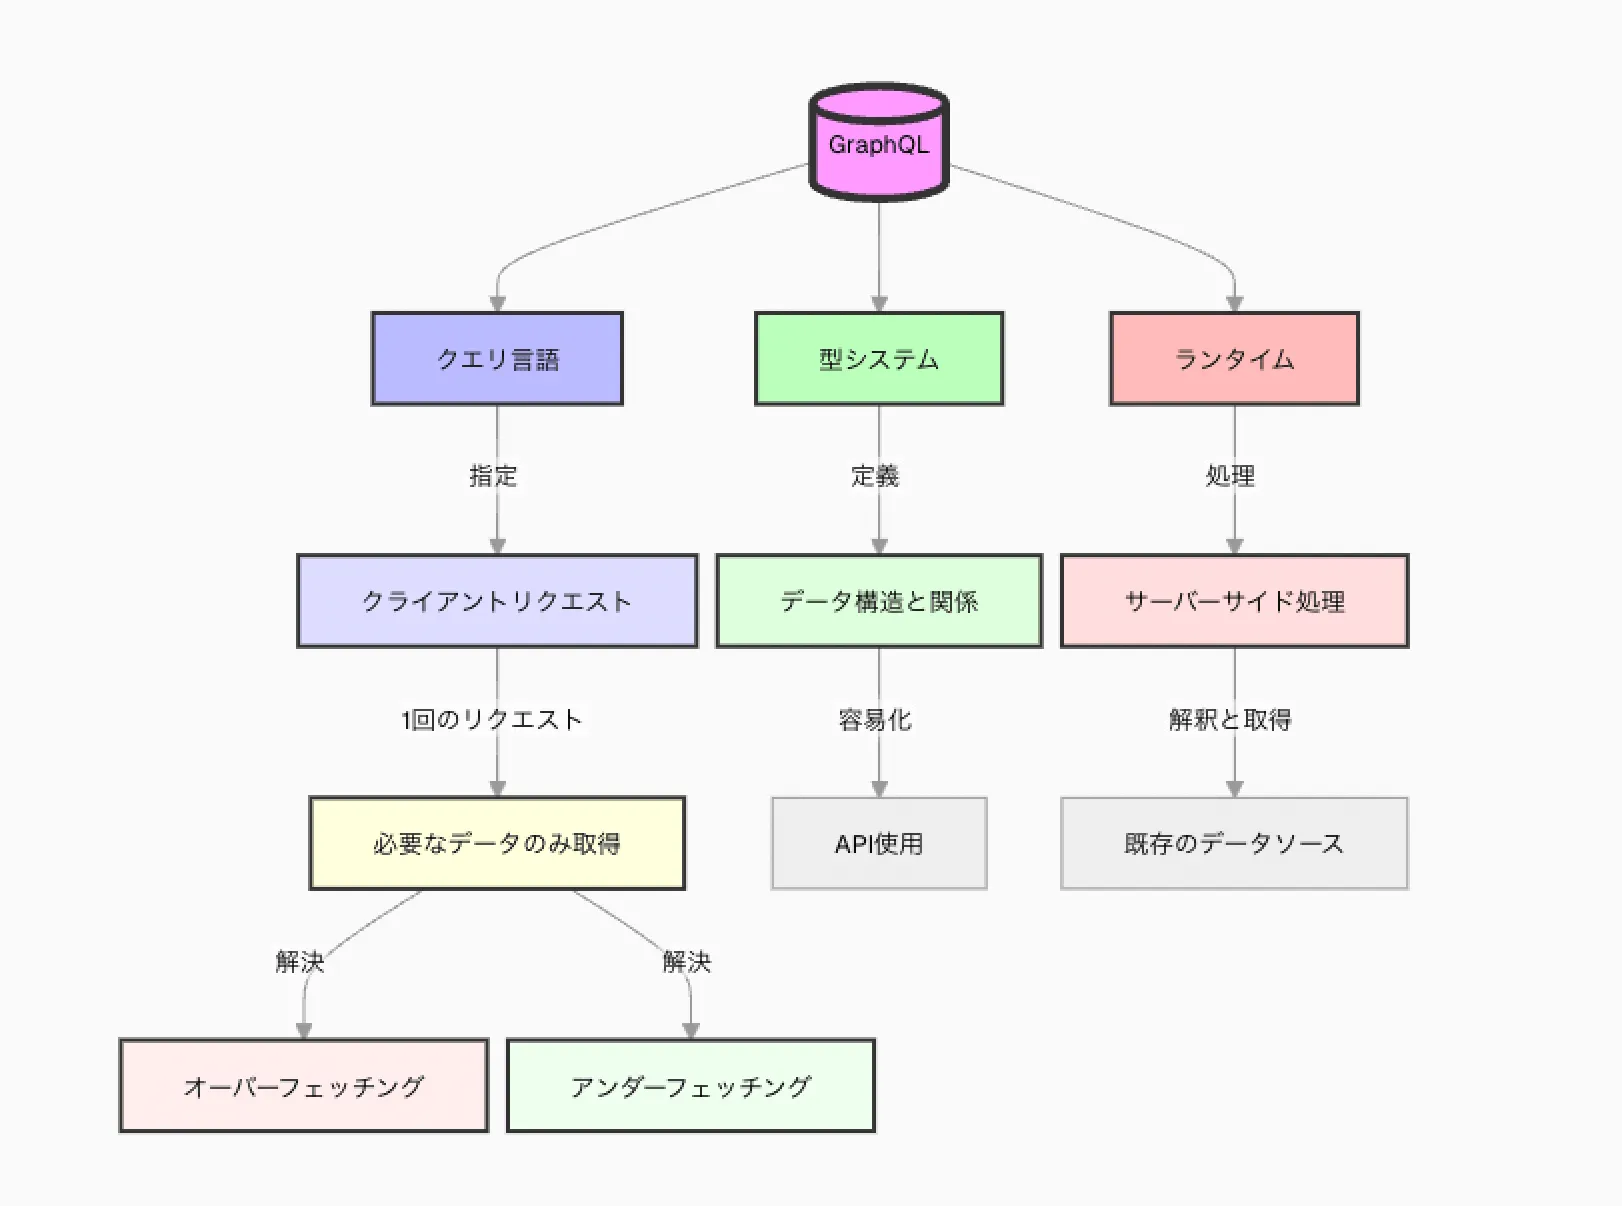
GraphQLの定義
GraphQLは以下のように定義できます。
1. クエリ言語: クライアントがサーバーに対して、必要なデータの構造を正確に指定するための言語です。
2. 型システム: データの構造と関係を明確に定義し、APIの使用を容易にします。
3. ランタイム: クエリを解釈し、既存のデータソースからデータを取得して結果を返すサーバーサイドの処理系です。
GraphQLの特徴は、クライアントが必要なデータだけを、1回のリクエストで取得できることです。これにより、従来のRESTful APIで問題となっていたオーバーフェッチング(不要なデータの取得)やアンダーフェッチング(必要なデータの取得漏れ)を解消します。
GraphQLの歴史と開発背景
GraphQLの誕生には興味深い背景があります:
- 2012年: Facebookがモバイルアプリケーションのパフォーマンス向上のために社内で開発を開始。
- 2015年7月: GraphQLの仕様が公開され、オープンソース化。
- 2016年9月: GraphQL仕様の安定版がリリース。
- 2018年11月: GraphQLがLinux Foundationに移管され、中立的な立場での開発が継続。
Facebookがグラフクエリ言語を開発した主な理由は、モバイルアプリケーションのパフォーマンス向上でした。モバイルデバイスの制約(低速なネットワーク、限られたストレージ)に対応するため、必要最小限のデータを効率的に取得する方法が求められていたのです。
GraphQLは、この課題に対する革新的な解決策として生まれました。データをグラフ構造として捉え、クライアントが必要なデータだけを柔軟に指定できるようにすることで、不要なデータ転送を減らし、アプリケーションの応答性を大幅に向上させることに成功しました。
現在、GraphQLは多くの大手テック企業(GitHub、Airbnb、Twitter等)で採用されており、Web開発のスタンダードの一つとして急速に普及しています。
GraphQLの基本概念
GraphQLを理解する上で重要な基本概念について説明します。これらの概念を把握することで、GraphQLの強力な機能を効果的に活用できるようになります。
スキーマ
スキーマはGraphQLのAPIにおける基礎となる部分です。スキーマは、APIで利用可能なデータ型とその関係を定義します。具体的には以下の要素で構成されます:
- 型(Types): データの構造を定義します。例えば、`User`や`Product`などのオブジェクト型があります。
- フィールド(Fields): 型に属する個々のデータ項目です。例えば、`User`型には`name`や`email`などのフィールドがあります。
- クエリ(Query): データの読み取り操作を定義します。
- ミューテーション(Mutation): データの作成・更新・削除操作を定義します。
スキーマは、GraphQL APIのコントラクトとして機能し、クライアントとサーバー間の通信の基盤となります。
クエリ
クエリは、GraphQLにおけるデータ取得の方法です。クライアントは、必要なデータの構造を正確に指定したクエリをサーバーに送信します。クエリの特徴は以下の通りです:
- 宣言的: 必要なデータの構造を明示的に指定します。
- 階層的: データの関係性を階層構造で表現できます。
- 型安全: スキーマで定義された型に基づいてクエリを作成します。
例えば、ユーザーの名前とその投稿のタイトルを取得するクエリは以下のようになります:
query {
  user(id: "123") {
    name
    posts {
      title
    }
  }
}
ミューテーション
ミューテーションは、サーバー側のデータを変更するための操作です。新しいデータの作成、既存データの更新、データの削除などがミューテーションに該当します。
ミューテーションの構造はクエリに似ていますが、操作の種類が異なります:
mutation {
  createUser(name: "John Doe", email: "john@example.com") {
    id
    name
    email
  }
}
この例では、新しいユーザーを作成し、作成されたユーザーの情報を返しています。
サブスクリプション
サブスクリプションは、GraphQLのリアルタイムデータ更新機能です。クライアントがサーバーの特定のイベントを監視し、変更があった場合にリアルタイムで通知を受け取ることができます。
サブスクリプションは、チャットアプリケーションやリアルタイム分析ツールなど、即時性が重要なアプリケーションで特に有用です。
subscription {
  newMessage {
    sender
    content
  }
}
この例では、新しいメッセージが作成されるたびに、そのメッセージの送信者と内容がクライアントにリアルタイムで通知されます。
これらの基本概念を理解することで、GraphQLの強力な機能を活用し、効率的でスケーラブルなAPIを設計・実装することができます。次のセクションでは、GraphQLの特徴について詳しく見ていきましょう。
GraphQLの特徴
GraphQLには、従来のAPIと比較して独自の特徴があります。これらの特徴が、GraphQLを多くの開発者から支持される技術にしています。ここでは、GraphQLの主要な特徴について詳しく解説します。
柔軟なデータ取得
GraphQLの最も重要な特徴の一つは、クライアントが必要なデータを正確に指定できるという点です。これにより、以下のメリットが生まれます:
1. オーバーフェッチングの防止: 不要なデータを取得することがなくなり、ネットワーク負荷を軽減します。
2. アンダーフェッチングの解消: 必要なデータを1回のリクエストで取得できるため、複数回のAPI呼び出しが不要になります。
3. フロントエンドの開発効率向上: バックエンドの変更なしに、クライアント側で必要なデータを柔軟に指定できます。
例えば、ユーザーの名前だけが必要な場合と、詳細情報が必要な場合で、同じエンドポイントを使いながら異なるデータを取得できます:
# 名前だけ取得
query {
  user(id: "123") {
    name
  }
}

# 詳細情報を取得
query {
  user(id: "123") {
    name
    email
    age
    posts {
      title
      content
    }
  }
}
型システム
GraphQLは強力な型システムを持っています。これにより、APIの設計と使用が明確になり、開発効率が向上します:
1. 自己文書化: スキーマが型情報を含むため、APIの構造が明確になります。
2. エラー検出: コンパイル時に型エラーを検出できるため、バグの早期発見が可能です。
3. IDEサポート: 型情報を活用して、コード補完や静的解析が可能になります。
4. クライアント-サーバー間の一貫性: 型システムにより、両者の認識の齟齬を防ぎます。
単一エンドポイント
GraphQLは通常、単一のエンドポイントを使用してすべての操作を処理します。これには以下のメリットがあります:
1. APIの管理が容易: 複数のエンドポイントを管理する必要がありません。
2. バージョン管理の簡素化: 新しいフィールドの追加や非推奨フィールドの管理が容易です。
3. クライアントの実装が簡単: 単一のURLに対してリクエストを送信するだけで良いです。
例えば、`/graphql`というエンドポイントに対して、すべてのクエリやミューテーションを送信することができます。
リアルタイムデータ取得
GraphQLのサブスクリプション機能を使用することで、リアルタイムデータ更新が可能になります:
1. リアルタイム通知: データの変更をリアルタイムでクライアントに通知できます。
2. 効率的なリソース利用: 必要なデータの更新のみを受け取ることができます。
3. 双方向通信: WebSocketなどの技術を使用して、サーバーからクライアントへのプッシュ通知が可能です。
これらの特徴により、GraphQLは現代のWeb開発における多くの課題を解決し、より効率的で柔軟なAPI設計を可能にしています。次のセクションでは、GraphQLの具体的なメリットについて詳しく見ていきましょう。
GraphQLのメリット
GraphQLは、その独自の設計思想と機能により、多くのメリットを開発者とユーザーにもたらします。ここでは、GraphQLの主要なメリットについて詳しく解説します。
オーバーフェッチングとアンダーフェッチングの解消
GraphQLの最大の利点の一つは、データの過不足を解消できることです。
- オーバーフェッチングの解消: クライアントは必要なデータのみを指定して取得できるため、不要なデータをネットワーク経由で転送する必要がありません。これにより、ネットワーク帯域の使用量が減少し、アプリケーションのパフォーマンスが向上します。
- アンダーフェッチングの解消: 1回のリクエストで必要なすべてのデータを取得できるため、複数回のAPI呼び出しが不要になります。これにより、ネットワークレイテンシが減少し、アプリケーションの応答性が向上します。
例えば、ユーザーのプロフィールページを表示する場合、従来のRESTful APIでは複数のエンドポイントにアクセスする必要がありましたが、GraphQLでは1回のクエリですべての必要データを取得できます:
query {
  user(id: "123") {
    name
    email
    posts {
      title
      comments {
        author {
          name
        }
        content
      }
    }
  }
}
API開発の効率化
GraphQLは、API開発プロセスを大幅に効率化します:
1. スキーマ駆動開発: GraphQLのスキーマは、APIの設計と実装の基盤となります。これにより、フロントエンドとバックエンドの開発者が共通の理解を持ちやすくなります。
2. 型安全性: 強力な型システムにより、開発時のエラー検出が容易になり、バグの早期発見につながります。また、IDEのサポートにより、開発効率が向上します。
3. 自己文書化: GraphQLのスキーマは、APIの構造とデータ型を明確に定義します。これにより、別途APIドキュメントを作成・管理する必要性が減少します。
4. 段階的な開発: 新しいフィールドや型を追加する際に、既存のクエリに影響を与えることなく拡張できます。これにより、APIの進化が容易になります。
フロントエンド開発の柔軟性向上
GraphQLは、フロントエンド開発者に大きな自由度を提供します:
1. データ取得の最適化: 必要なデータだけを取得できるため、パフォーマンスの最適化が容易になります。
2. クライアント側のキャッシュ管理: GraphQLクライアントライブラリ(Apollo ClientやRelay)を使用することで、効率的なキャッシュ管理が可能になります。
3. モックサーバーの利用: スキーマに基づいてモックサーバーを簡単に作成できるため、バックエンドの開発を待たずにフロントエンド開発を進められます。
4. クライアント側の型生成: スキーマから自動的に型定義を生成できるため、TypeScriptなどの静的型付け言語との相性が良く、型安全な開発が可能です。
バージョニングの簡素化
GraphQLは、APIのバージョニングを簡素化します:
1. スキーマの進化: 新しいフィールドの追加や非推奨フィールドの管理が容易です。クライアントは必要なフィールドだけを指定するため、バックエンドの変更がクライアントに与える影響を最小限に抑えられます。
2. 非推奨フィールドの管理: フィールドに`@deprecated`ディレクティブを使用することで、非推奨フィールドを明示的に示すことができます。これにより、APIの進化を管理しやすくなります。
3. グラフQLスキーマ・スティッチング: 複数のスキーマを組み合わせて1つの大きなスキーマを作成できます。これにより、マイクロサービスアーキテクチャにおけるAPI統合が容易になります。
これらのメリットにより、GraphQLは現代のWeb開発における多くの課題を解決し、より効率的で柔軟なアプリケーション開発を可能にします。しかし、すべての技術と同様に、GraphQLにもデメリットがあります。次のセクションでは、GraphQLの潜在的な課題について説明します。
GraphQLのデメリット
GraphQLは多くの利点を持つ一方で、いくつかの課題や制限も存在します。これらを理解することで、プロジェクトにGraphQLを採用する際の適切な判断ができるようになります。
学習曲線の存在
GraphQLは従来のRESTful APIとは異なるパラダイムを採用しているため、新しい概念や技術を学ぶ必要があります:
1. 新しい概念: スキーマ、クエリ言語、リゾルバーなど、GraphQL特有の概念を理解する必要があります。
2. ツールとライブラリの学習: Apollo ServerやGraphQL Yogaなどのサーバーライブラリ、Apollo ClientやRelayなどのクライアントライブラリの使い方を学ぶ必要があります。
3. ベストプラクティスの習得: N+1問題の解決やスキーマ設計のベストプラクティスなど、GraphQL特有の最適化テクニックを学ぶ必要があります。
これらの学習コストは、特に小規模なプロジェクトや短期的なデッドラインがある場合には障壁となる可能性があります。
キャッシュの複雑さ
GraphQLのフレキシブルなデータ取得は利点である一方、キャッシュ管理を複雑にする可能性があります:
1. 細粒度のキャッシュ: 各フィールドレベルでキャッシュを管理する必要があり、RESTful APIよりも複雑になる可能性があります。
2. 部分的な更新: ミューテーション後のキャッシュの部分的な更新が必要となり、適切に管理しないとデータの整合性が損なわれる可能性があります。
3. キャッシュの無効化: クエリの結果が動的に変化する場合、適切なタイミングでキャッシュを無効化する必要があります。
これらの課題に対処するため、Apollo ClientやRelayなどの専用のクライアントライブラリを使用することが推奨されますが、これらのライブラリの学習も必要になります。
セキュリティ面での考慮事項
GraphQLの柔軟性は、セキュリティ面でいくつかの課題をもたらします:
1. 複雑なクエリによるDoS攻撃: クライアントが非常に複雑で深いネストのクエリを送信することで、サーバーリソースを枯渇させる可能性があります。
2. 過剰な情報開示: スキーマが公開されているため、APIの構造が攻撃者に容易に把握される可能性があります。
3. 認可の複雑さ: フィールドレベルでの細かい認可制御が必要となり、実装が複雑になる可能性があります。
これらの課題に対処するためには、クエリの複雑さに制限を設けたり、適切な認可メカニズムを実装したりする必要があります。
パフォーマンスへの影響
GraphQLは柔軟なデータ取得を可能にしますが、適切に実装しないとパフォーマンスに悪影響を与える可能性があります:
1. N+1問題: ネストされたリレーションを含むクエリで、データベースへの過剰なクエリが発生する可能性があります。
2. 大量データの取得: クライアントが必要以上に大量のデータを要求する可能性があります。
3. バッチ処理の複雑さ: 複数のリソースを一度に操作するバッチ処理の実装が、RESTful APIと比較して複雑になる可能性があります。
これらの課題に対処するためには、DataLoaderのような最適化ツールの使用や、クエリの複雑さに制限を設けるなどの対策が必要です。
GraphQLのこれらのデメリットは、適切な設計と実装によって多くの場合緩和または解決できます。次のセクションでは、GraphQLとRESTを比較し、それぞれの適用場面について考察します。
GraphQLとRESTの比較
GraphQLとRESTは、どちらもAPIを設計・実装するための重要なアプローチです。それぞれに長所と短所があり、プロジェクトの要件に応じて適切な選択をする必要があります。ここでは、両者の主要な違いを比較し、それぞれの適用場面について解説します。
データ取得の違い
GraphQLとRESTでは、データ取得の方法が大きく異なります:
1. GraphQL:
- クライアントが必要なデータを正確に指定できる
- 1回のリクエストで複数のリソースを取得可能
- オーバーフェッチングとアンダーフェッチングを防ぐ
2. REST:
- サーバーが定義したエンドポイントごとに固定のデータ構造を返す
- 複数のリソースを取得する場合、複数回のリクエストが必要になることが多い
- エンドポイントによっては、不要なデータも含めて返される場合がある
エンドポイントの扱い
エンドポイントの設計と使用方法も大きく異なります:
1. GraphQL:
- 通常、単一のエンドポイント(例:`/graphql`)を使用
- クエリの内容によってデータの取得や操作を行う
- エンドポイントの数を増やさずにAPIを拡張できる
2. REST:
- リソースごとに異なるエンドポイントを持つ(例:`/users`, `/posts`, `/comments`)
- HTTPメソッド(GET, POST, PUT, DELETE等)を使用してリソースを操作
- 新しい機能を追加する際に新しいエンドポイントが必要になることが多い
3.ドキュメンテーション
APIのドキュメンテーションにおいても、GraphQLとRESTには違いがあります:
- GraphQL: スキーマが自己文書化機能を持つ型システムにより、APIの構造が明確に定義されるGraphiQLやGraphQL Playgroundなどの対話的なツールを使用して、APIを容易に探索できる
- スキーマが自己文書化機能を持つ
- 型システムにより、APIの構造が明確に定義される
- GraphiQLやGraphQL Playgroundなどの対話的なツールを使用して、APIを容易に探索できる
- REST: 別途APIドキュメントを作成・管理する必要があるSwagger/OpenAPIなどのツールを使用してドキュメントを生成・管理することが一般的エンドポイントごとにドキュメントを作成する必要がある
- 別途APIドキュメントを作成・管理する必要がある
- Swagger/OpenAPIなどのツールを使用してドキュメントを生成・管理することが一般的
- エンドポイントごとにドキュメントを作成する必要がある
4.バージョニング
APIの進化と維持管理における違い:
- GraphQL: スキーマの段階的な進化が可能新しいフィールドの追加が容易で、既存のクエリに影響を与えない非推奨フィールドの管理が容易(@deprecatedディレクティブの使用)
- スキーマの段階的な進化が可能
- 新しいフィールドの追加が容易で、既存のクエリに影響を与えない
- 非推奨フィールドの管理が容易(@deprecatedディレクティブの使用)
- REST: 新しいバージョンのAPIを作成することが一般的(例:/api/v1, /api/v2)大きな変更を加える際に、クライアント側の更新が必要になることが多いバージョン間の互換性維持が難しい場合がある
- 新しいバージョンのAPIを作成することが一般的(例:/api/v1, /api/v2)
- 大きな変更を加える際に、クライアント側の更新が必要になることが多い
- バージョン間の互換性維持が難しい場合がある
5.キャッシュ
キャッシュの実装と管理方法の違い:
- GraphQL: クライアント側でのキャッシュ管理が複雑になる可能性があるフィールドレベルでのキャッシュが可能Apollo ClientやRelayなどのライブラリを使用して効率的なキャッシュ管理が可能
- クライアント側でのキャッシュ管理が複雑になる可能性がある
- フィールドレベルでのキャッシュが可能
- Apollo ClientやRelayなどのライブラリを使用して効率的なキャッシュ管理が可能
- REST: HTTPの標準的なキャッシュメカニズムを利用できるリソースレベルでのキャッシュが一般的サーバー側でのキャッシュ制御が比較的容易
- HTTPの標準的なキャッシュメカニズムを利用できる
- リソースレベルでのキャッシュが一般的
- サーバー側でのキャッシュ制御が比較的容易
6.適用場面
GraphQLとRESTは、それぞれ以下のような場面で適していると考えられます:
GraphQLが適している場面:
- 複雑なデータ構造を持つアプリケーション
- モバイルアプリケーション(帯域幅とレイテンシの最適化が重要)
- 頻繁に変更される可能性のあるAPI
- マイクロサービスアーキテクチャ(複数のサービスを統合するGateway API)
- リアルタイムデータ更新が必要なアプリケーション
RESTが適している場面:
- シンプルなCRUD操作が中心のアプリケーション
- キャッシュの重要性が高いアプリケーション
- ファイルのアップロード/ダウンロードなど、単純なリソース操作が主なアプリケーション
- 公開API(外部開発者が利用しやすい)
- レガシーシステムとの統合が必要な場合
まとめ
GraphQLとRESTは、それぞれに長所と短所があります。プロジェクトの要件、開発チームのスキルセット、パフォーマンス要件などを考慮して、適切な方を選択することが重要です。また、両者を組み合わせて使用することも可能です。例えば、主要な機能にはGraphQLを使用し、ファイルアップロードなどの単純な操作にはRESTfulエンドポイントを使用するといったアプローチも考えられます。
最終的には、アプリケーションの具体的なニーズに基づいて判断し、必要に応じて両方のアプローチを柔軟に採用することが、最適なソリューションを生み出す鍵となります。